
Příklad 10: Rozsah výběru pro podíl
Vzorcovník zatím není na e-learningu. Vyučující slíbili, že ho brzy nahrají a že bude v učebně i při testu. Až bude venku, upravím ruční výpočty tak, aby odkazovaly na vzorce z něj.
Zadání
Stanovte potřebný rozsah výběru pro šetření, jehož předmětem je zjištění, zda se obyvatelé Šluknova zamýšleli nad tím, že by se z města vystěhovali. Z předvýzkumu bylo zjištěno, že podíl těch, kteří o tom uvažovali již někdy, je 20 %. Odhady chceme provádět se spolehlivostí 1-α = 0,95 a připouštíme chybu ve výši 2 %.
Zadání příkladu, pokračování:
Jak by se požadovaný rozsah výběru změnil, kdybychom byli ochotni připustit chybu 4 %?
Zadání příkladu, pokračování:
Jak by se požadovaný rozsah výběru změnil, kdybychom chtěli odhadnout maximální podíl těch, kteří uvažovali o vystěhování se ze Šluknova?
| Co známe | Hodnota |
|---|---|
| podíl z předvýzkumu p | 0,2 |
| spolehlivost 1 − α | 0,95 |
| přípustná chyba Δ | 0,02 (1. pokračování: 0,04) |
Typ proměnné a co z toho plyne
- „Uvažoval o vystěhování: ano / ne“ je alternativní proměnná, odhaduje se podíl π. Rozsah se počítá z přípustné chyby odhadu relativní četnosti.
- U podílu se vždy bere kvantil u (normované normální rozdělení).
- Chyba „2 %“ znamená 2 procentní body, do vzorce Δ = 0,02 (ve stejných jednotkách jako p = 0,2).
- Základní případ je oboustranný odhad s vracením → u1−α/2. „Maximální podíl“ je jednostranný odhad → u1−α.
- Rozsah se zaokrouhluje vždy nahoru.
Postup s tahákem
Mít po ruce: tahák se vzorci, str. 1. Vzorec i kvantily u jsou na taháku. Procedura Sample Size Determination ve Statgraphicsu dá jiná čísla (1 671 místo 1 537), do testu se píše výpočet podle vzorce.
1. Kvantily
Tahák: Hladiny na Z rozdělení, hladiny spolehlivosti
2. Dosadit
Tahák: Odhad minimálního rozsahu výběru, podle proporce
Na taháku je překlep: ve vzorci stojí p(p − 1), správně je p(1 − p). S p(p − 1) by vyšlo záporné číslo.
Δ dosadit jako desetinné číslo (2 % = 0,02), stejně jako p. Rozsah se zaokrouhluje vždy nahoru.
3. Kontrola v Sample Size Determination (nepovinné)
Tools > Sample Size Determination > One Sample, Binomial Proportion, 0,2. V Options Absolute Error = 0,02 (nebo 0,04), Confidence level 95 %. Pro maximální podíl Alternative Hypothesis = Less Than.
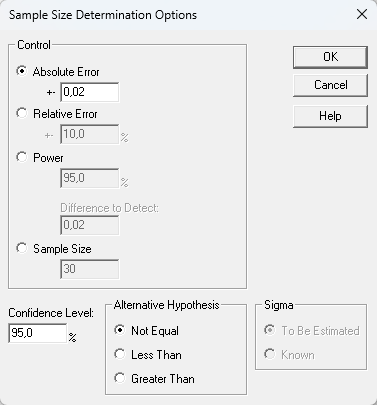
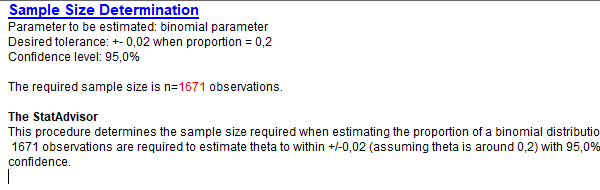
Katedra: výsledek se liší, protože „zde jsou používány kvantily rozdělení F“. Na testu platí výpočet podle vzorce.
Ruční řešení po krocích
a) Základní případ: Δ = 2 %, oboustranný odhad
n = 1 537 respondentů
b) 1. pokračování: chyba 4 %
n = 385 respondentů, zhruba čtvrtina původního rozsahu.
Chyba je ve jmenovateli na druhou: dvojnásobná chyba = čtvrtinový rozsah (1 536,64 / 4 = 384,16).c) 2. pokračování: maximální podíl (jednostranný odhad), Δ = 2 %
n = 1 083 respondentů, o 454 méně než u oboustranného odhadu.
Jednostranný odhad potřebuje menší výběr, protože u0,95 = 1,645 < u0,975 = 1,96.Interpretace
Na co se můžou zeptat v testu
Co dělat, když z předvýzkumu podíl neznáme?
Dosadit p = 0,5, kdy je p(1 − p) = 0,25 největší a rozsah vyjde „na jistotu“: 1,96² · 0,25 / 0,0004 = 2 401 respondentů. To je odhad podle obecného vzorce, v řešených příkladech katedry tato varianta není.
Jak se rozsah změní při spolehlivosti 99 % (Δ = 2 %)?
u0,995 = 2,576: 2,576² · 0,16 / 0,0004 = 2 654,3 → 2 655 respondentů. Vyšší spolehlivost potřebuje větší výběr.
Kolik by stačilo při výběru bez vracení z 6 500 obyvatel?
nBV = 6 500 · 1 537 / (6 500 + 1 537) = 1 243,1 → 1 244 respondentů. Tady je úspora velká, protože výběr tvoří skoro čtvrtinu populace.
Proč u podílu nikdy nepoužíváme t?
Vzorec pro π stojí na aproximaci normálním rozdělením (proto podmínka n · p(1 − p) > 9). Rozptyl se počítá přímo z p, nic se zvlášť neodhaduje ze směrodatné odchylky, takže t se tu nepoužívá.